
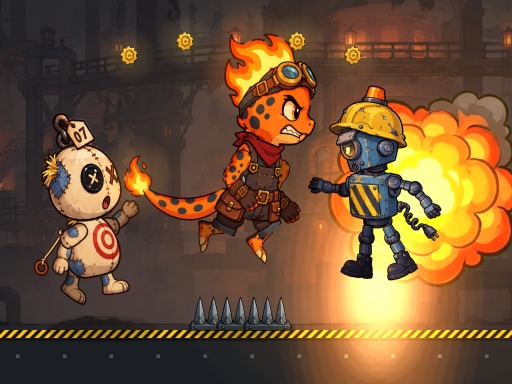
Hazard Pay 在每次尝试只设定一个目的时更容易理解。Hazard Pay 鼓励先观察再提速,因为当前画面已经展示目标、危险、安全空间和下一项决策。请把可玩页面与本攻略同时打开,并用实时版本核对建议。Hazard Pay 的发行方直连 iframe 已返回 HTTP 200,Chrome 也渲染出真实游戏画面。本文只使用已列出的操作和可见机制,不虚构升级、敌人或捷径。用 Hazard Pay 测试一条路线,记录第一次失败原因,再带着一个修正重试。
从已验证规则开始
明确真实目标
Hazard Pay 在这一部分采用已验证规则:工厂用消失地板、后退的门和落点尖刺惩罚未经验证的直觉。操作前,Hazard Pay 应把这条规则与“明确真实目标”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
区分事实与猜测
Hazard Pay 在这一部分采用已验证规则:六十个手工班次会把每个已暴露陷阱变成重开后仍然有效的路线知识。操作前,Hazard Pay 应把这条规则与“区分事实与猜测”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
读取完整游戏区域
定位停止点和危险
Hazard Pay 在这一部分采用已验证规则:Cinder 可蹬墙跳,Pip 可二段跳,Rivet 可悬停并扫描,因此角色选择会改变路线。操作前,Hazard Pay 应把这条规则与“定位停止点和危险”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
保护返回路线
Hazard Pay 在这一部分采用已验证规则:A、D 与方向键负责移动,跳跃键支持不同高度,Down 可穿过薄平台。操作前,Hazard Pay 应把这条规则与“保护返回路线”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
建立可靠开局
选择保守第一步
Hazard Pay 在这一部分采用已验证规则:R 能快速重开当前房间,从而只修正一次失败决策而不必推翻全部计划。操作前,Hazard Pay 应把这条规则与“选择保守第一步”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
建立可重复顺序
Hazard Pay 在这一部分采用已验证规则:赚到的危险津贴可解锁帽子与轨迹,但外观不能替代精确移动练习。操作前,Hazard Pay 应把这条规则与“建立可重复顺序”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
控制每一次输入
使用已验证操作
Hazard Pay 在这一部分采用已验证规则:可靠尝试会从确认安全的地面试探,暴露一个触发器,并在下一轮执行修正后的跳跃。操作前,Hazard Pay 应把这条规则与“使用已验证操作”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
让输入长度匹配场景
Hazard Pay 在这一部分采用已验证规则:工厂用消失地板、后退的门和落点尖刺惩罚未经验证的直觉。操作前,Hazard Pay 应把这条规则与“让输入长度匹配场景”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
从失败中恢复
找出第一个错误决策
Hazard Pay 在这一部分采用已验证规则:六十个手工班次会把每个已暴露陷阱变成重开后仍然有效的路线知识。操作前,Hazard Pay 应把这条规则与“找出第一个错误决策”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
每次只改变一个变量
Hazard Pay 在这一部分采用已验证规则:Cinder 可蹬墙跳,Pip 可二段跳,Rivet 可悬停并扫描,因此角色选择会改变路线。操作前,Hazard Pay 应把这条规则与“每次只改变一个变量”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
规划长期进度
按实际短板投入进度
Hazard Pay 在这一部分采用已验证规则:A、D 与方向键负责移动,跳跃键支持不同高度,Down 可穿过薄平台。操作前,Hazard Pay 应把这条规则与“按实际短板投入进度”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
稳定后再提高难度
Hazard Pay 在这一部分采用已验证规则:R 能快速重开当前房间,从而只修正一次失败决策而不必推翻全部计划。操作前,Hazard Pay 应把这条规则与“稳定后再提高难度”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
复核可重复路线
确认已经证明的顺序
Hazard Pay 在这一部分采用已验证规则:赚到的危险津贴可解锁帽子与轨迹,但外观不能替代精确移动练习。操作前,Hazard Pay 应把这条规则与“确认已经证明的顺序”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
下一局检查清单
让下一次尝试可衡量
Hazard Pay 在这一部分采用已验证规则:可靠尝试会从确认安全的地面试探,暴露一个触发器,并在下一轮执行修正后的跳跃。操作前,Hazard Pay 应把这条规则与“让下一次尝试可衡量”的当前目标连接起来,并保留一个可见的安全恢复选项。一次可衡量的 Hazard Pay 尝试只改变一个决策,等待结果明确后再增加输入。反馈不清楚时,Hazard Pay 应优先保护位置、空间和可恢复性,因为稳定状态能保留更多信息。失败后要寻找 Hazard Pay 中第一个被破坏的步骤,而不是只看最后的失败动画。让 Hazard Pay 在相似条件下重复,直到修正顺序连续成功两次,再增加速度、风险或更高目标。
- Hazard Pay 在首次输入前说明目标;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 查看完整画面而不是追逐最近奖励;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 保留安全停止点或恢复点;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 让每个已验证操作都有明确目的;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 失败后只改变一个决策;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 用等价尝试验证路线;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 针对上一局暴露的短板投入资源;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 开局稳定后才增加速度;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 先保护完成条件再追逐可选奖励;随后 Hazard Pay 检查结果并保留有效证据。
- Hazard Pay 为下一局留下一个书面修正;随后 Hazard Pay 检查结果并保留有效证据。
打开 Hazard Pay 前先设定一个可衡量目标。Hazard Pay 应从完整扫描开始,用有意图的输入推进,并在状态改变时短暂停顿。路线失败时,让 Hazard Pay 指出最早的错误决策,只修正该步骤并重复可比较的尝试。一次成功的 Hazard Pay 练习不是偶然通关,而是一条能够解释、重复和继续优化的路线。